포즈–영상 융합
포즈 추정의 품질과 영상의 시각 맥락을 함께 쓰는 학습형 융합을 연구합니다. CareBridge에서 포즈 인코더와 VLM을 결합해 본 경험에서 출발합니다.
신규 R&D · CareBridge 기반
픽셀와이가 독자적으로 설계하는시공간 비전-언어 모델
Pixel Y ST-VLM
영상 속 행동을 이해하는 독자 비전-언어 모델
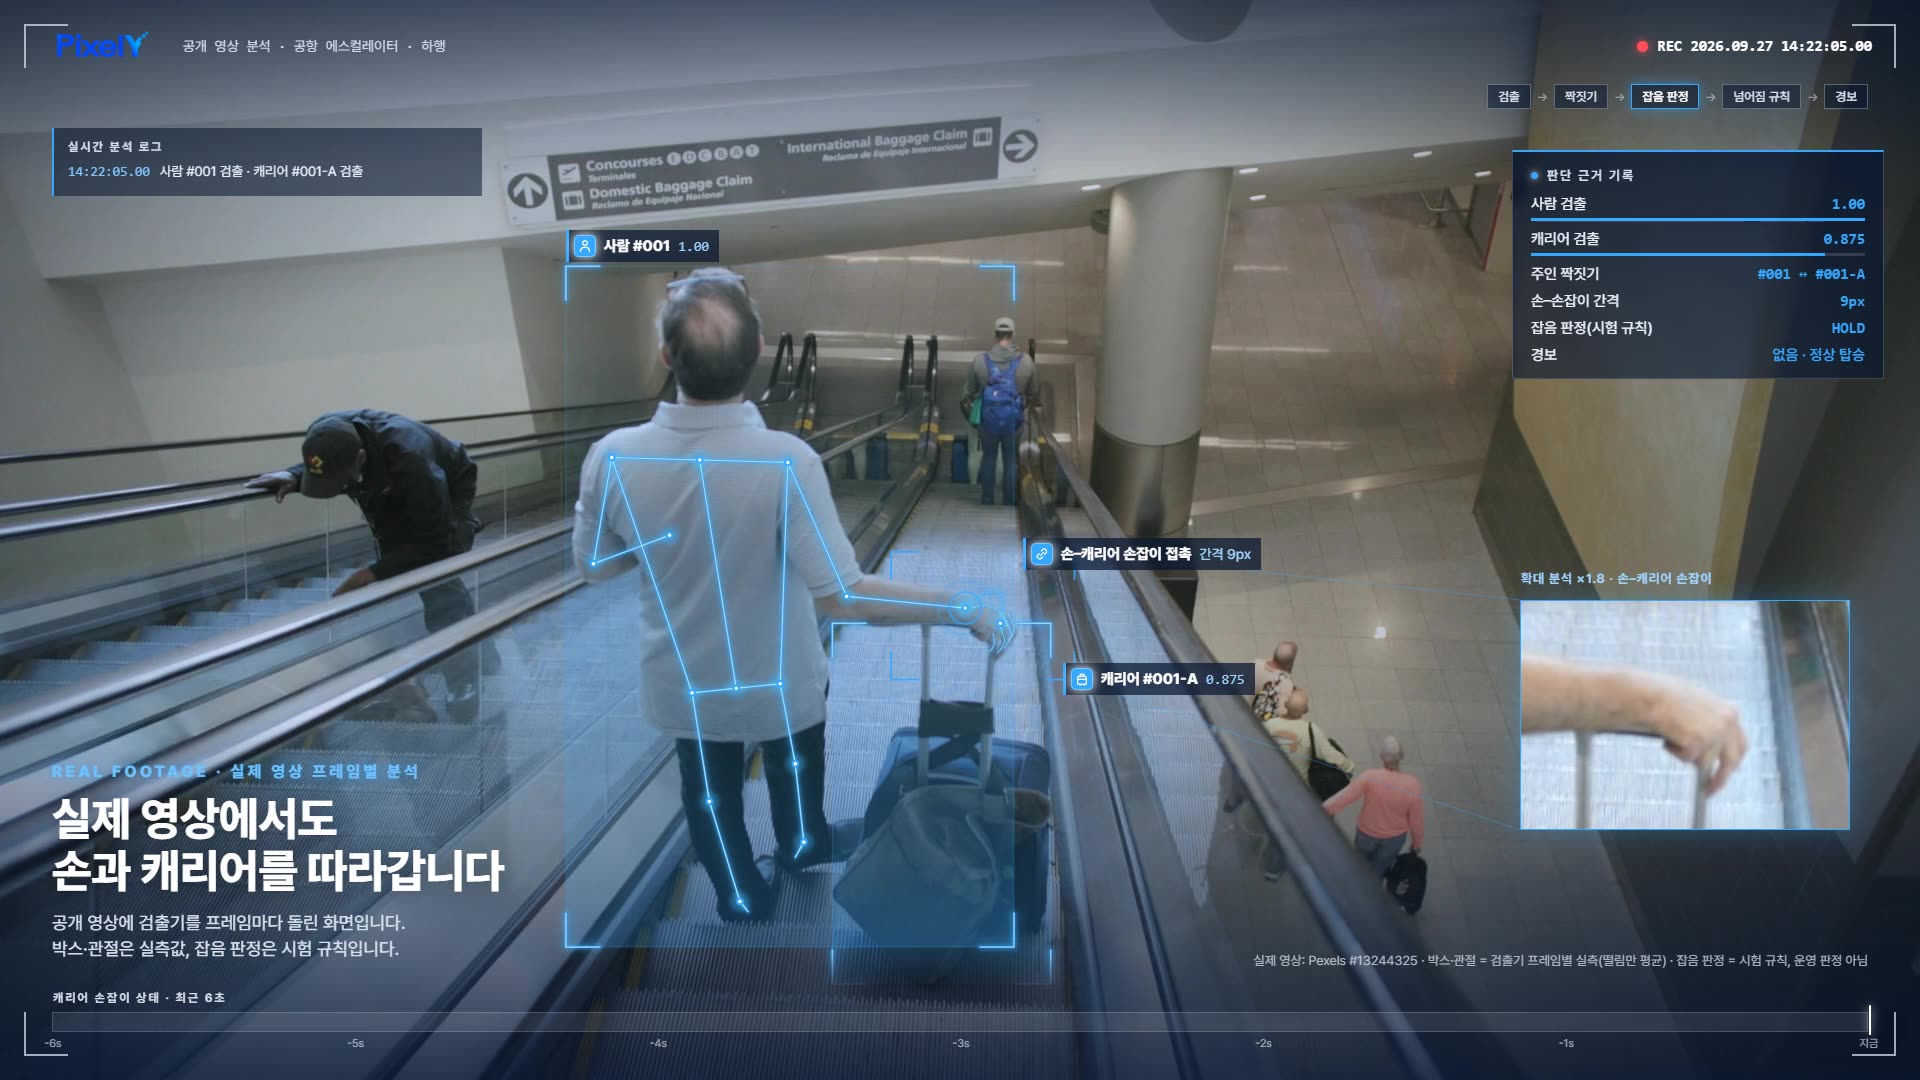
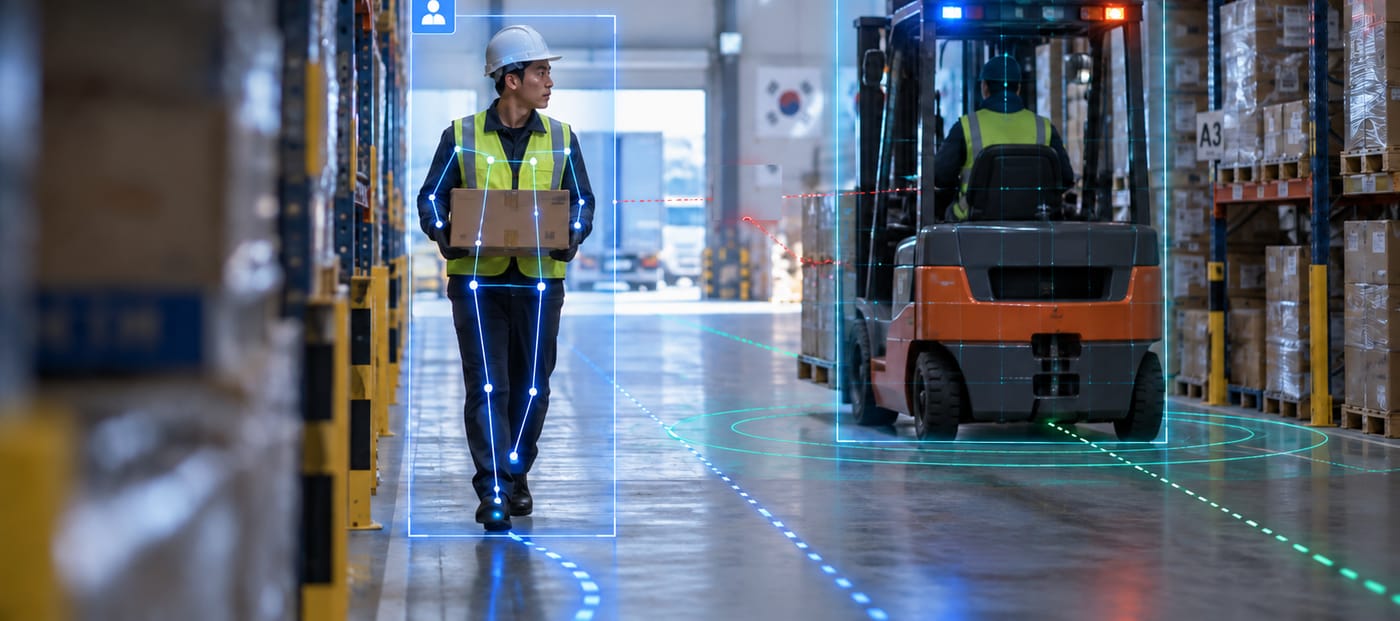
실제 영상에 검출기를 프레임마다 돌린 화면
개발 기록
검출·연관·시험 판정을 원본 장면과 대조한 기록이에요.
손잡이를 놓은 캐리어, 혼자 굴러 내려가는 짐, 넘어진 승객. 기존 CCTV 영상 속 사람의 행동을 이해하고, 확신할 때만 알립니다.
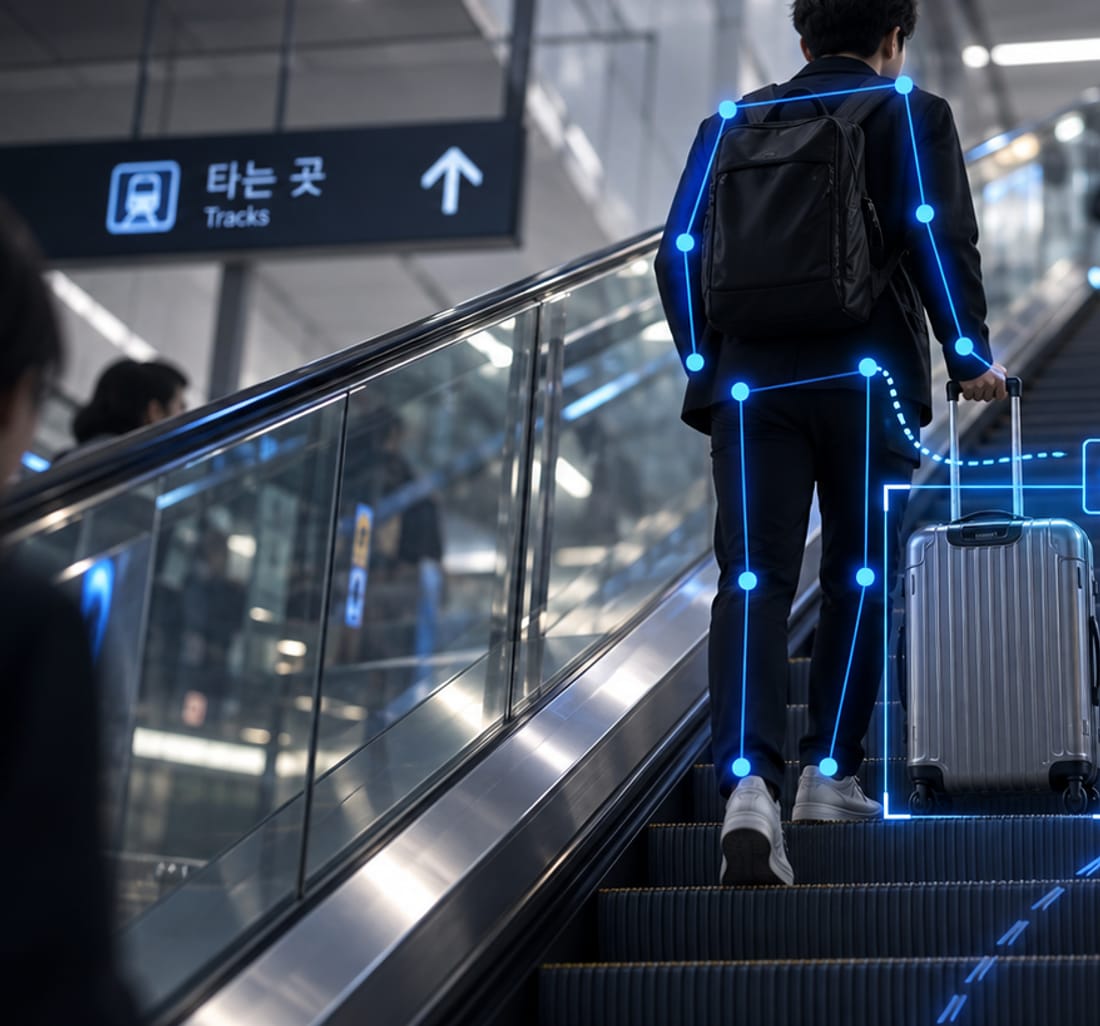
사람과 캐리어를 각각 찾아 주인을 짝지은 뒤, 손과 손잡이가 맞닿아 있는지를 장면으로 판단합니다. 잘 잡고 있으면 경보 없이 지켜봅니다.
Vision Core · Intent Reasoner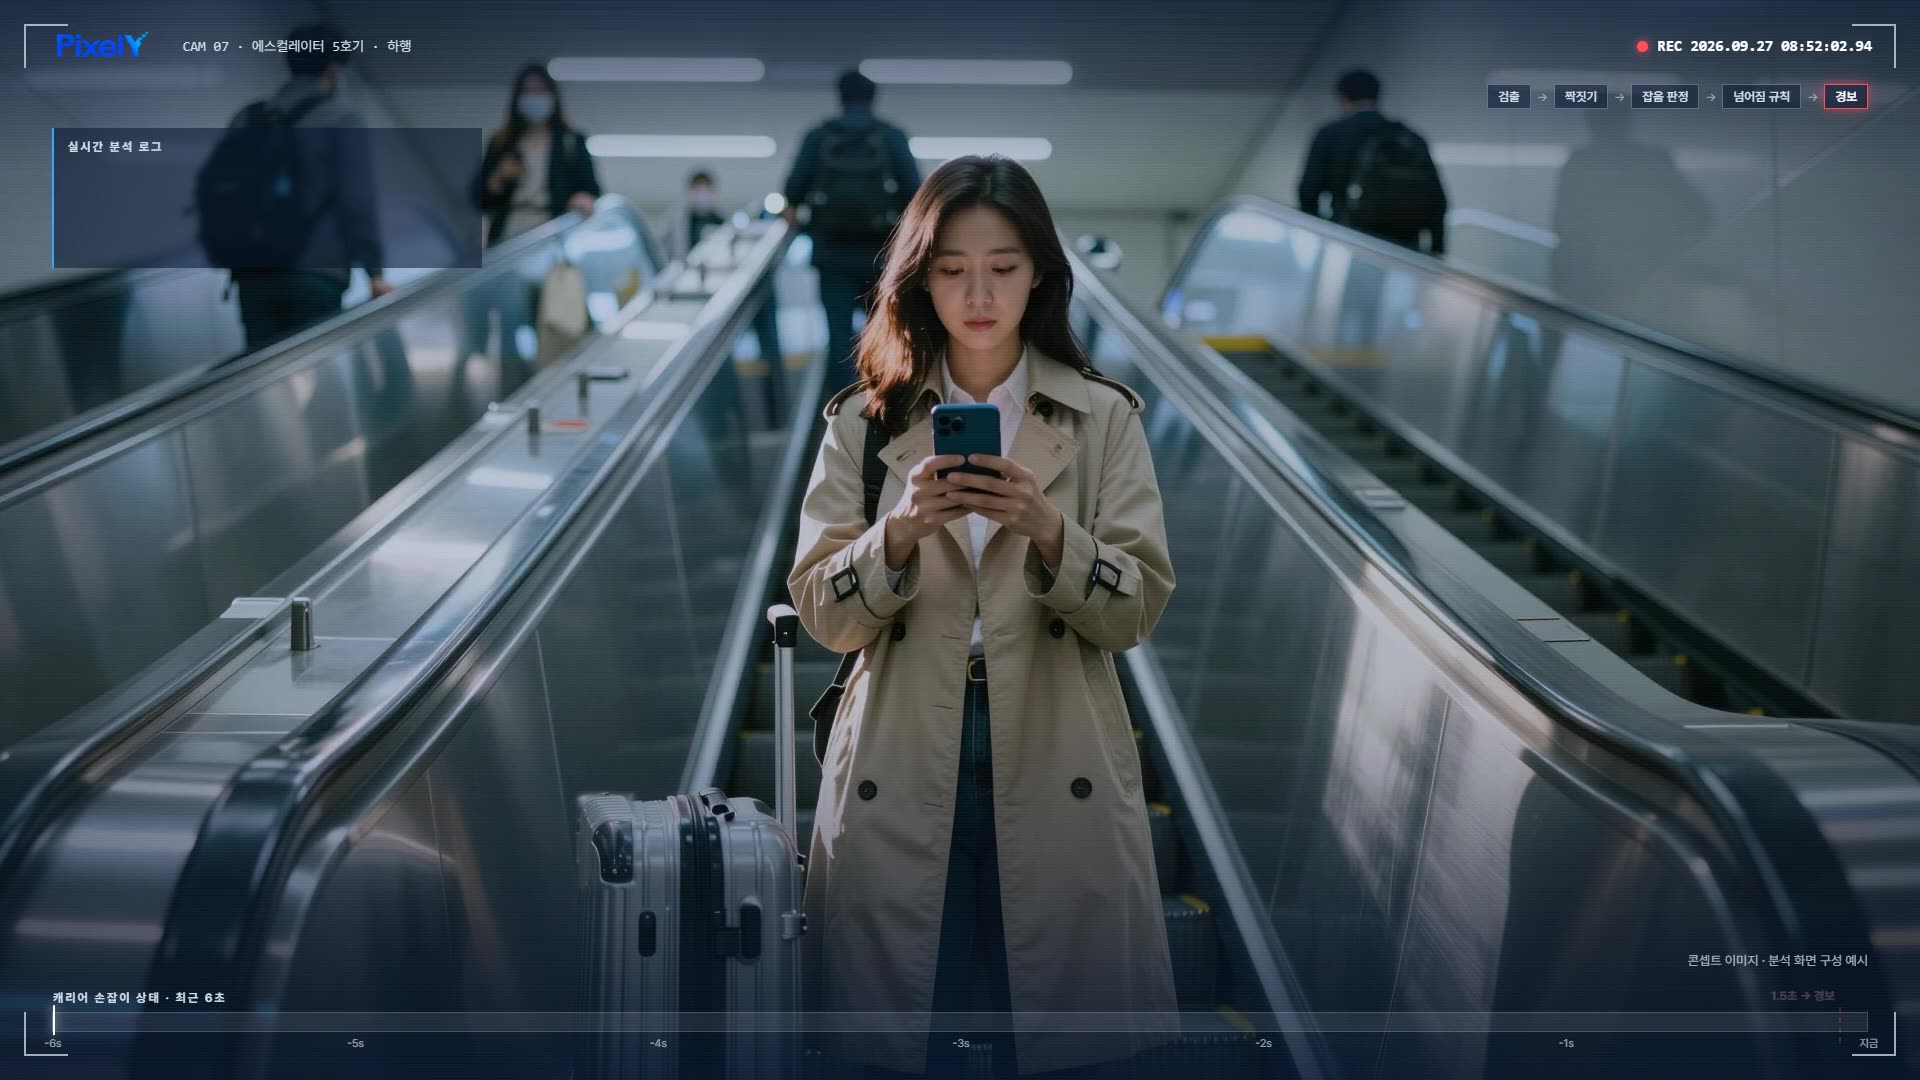
휴대폰을 보다 손이 손잡이에서 떨어지면 그때부터 시간을 재고, 정해진 시간을 넘기면 안내 방송으로 알립니다. 잠깐 가려져도 끊기지 않고 이어서 셉니다.
Grip Timer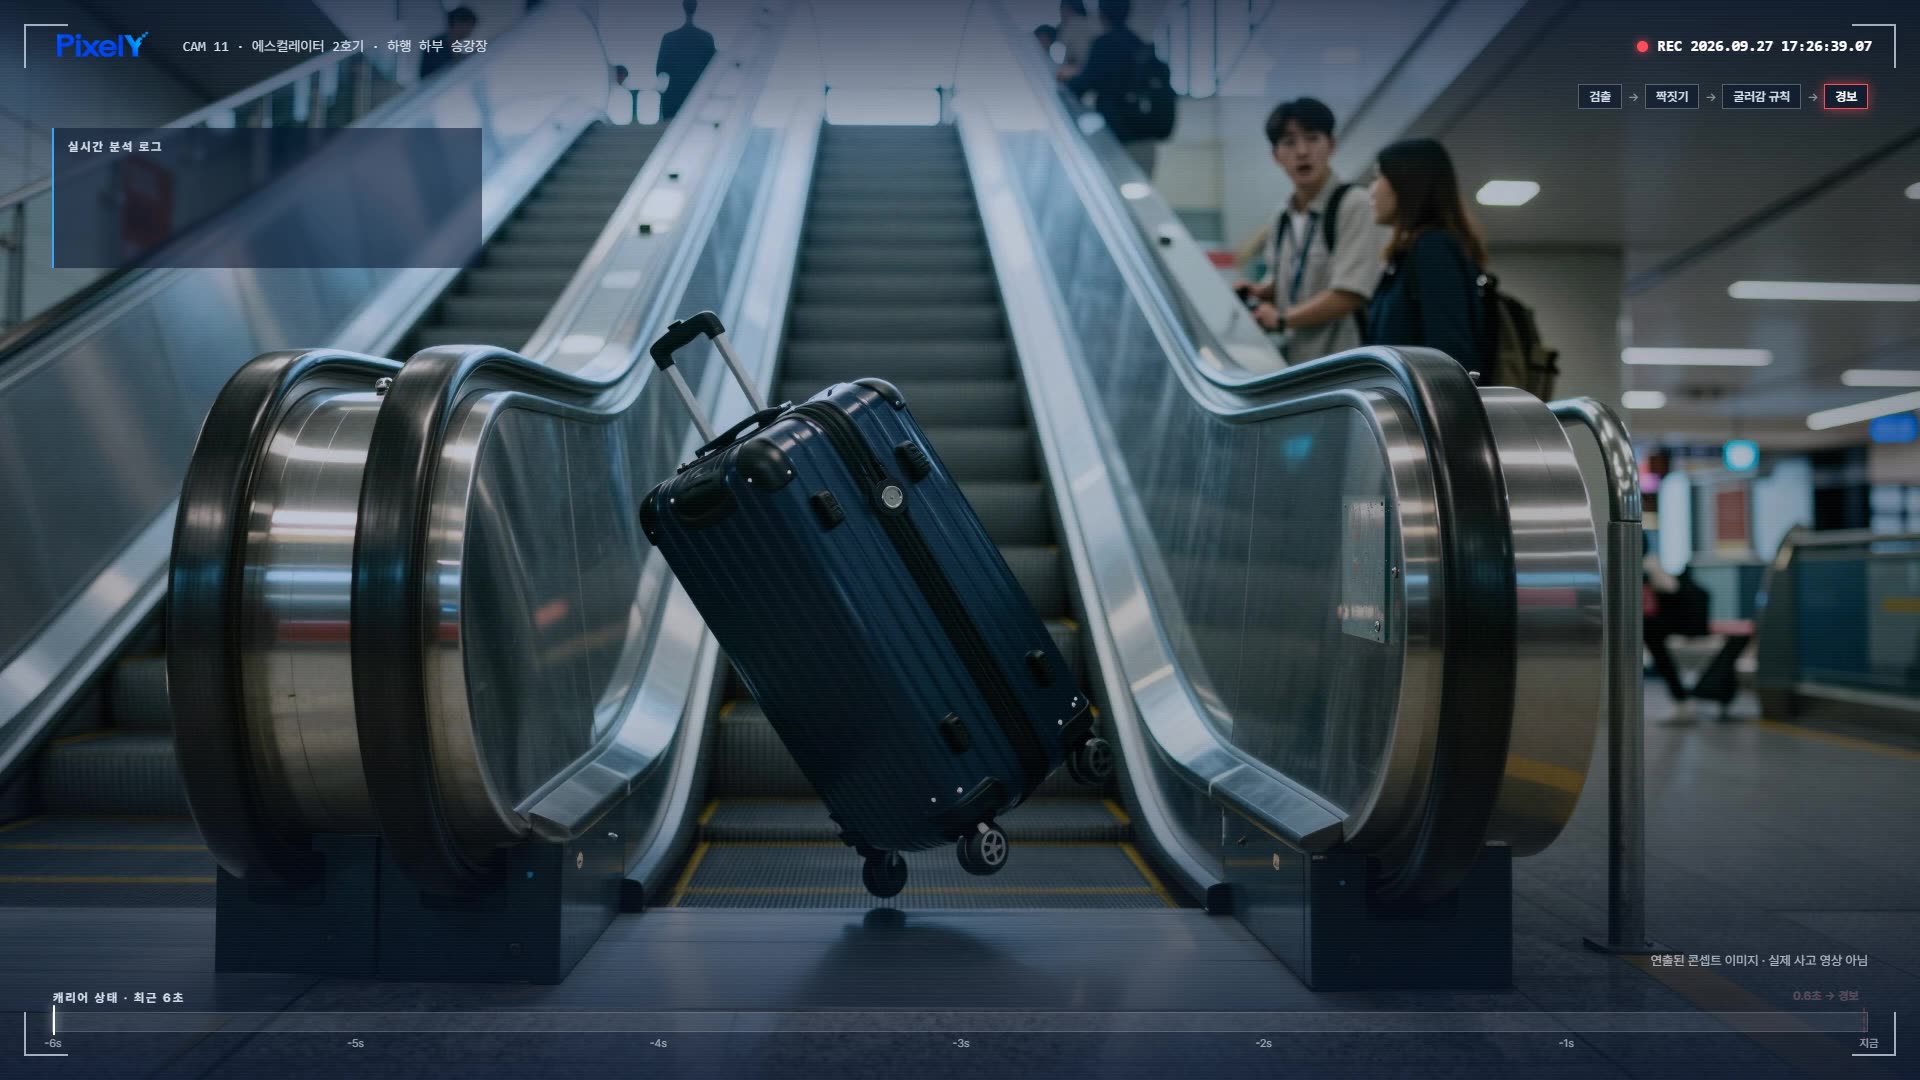
주인 손을 떠나 경사를 따라 내려오는 캐리어를 궤적으로 쫓아, 경광등과 방송으로 아래쪽 승객에게 먼저 알립니다.
Runaway Sentinel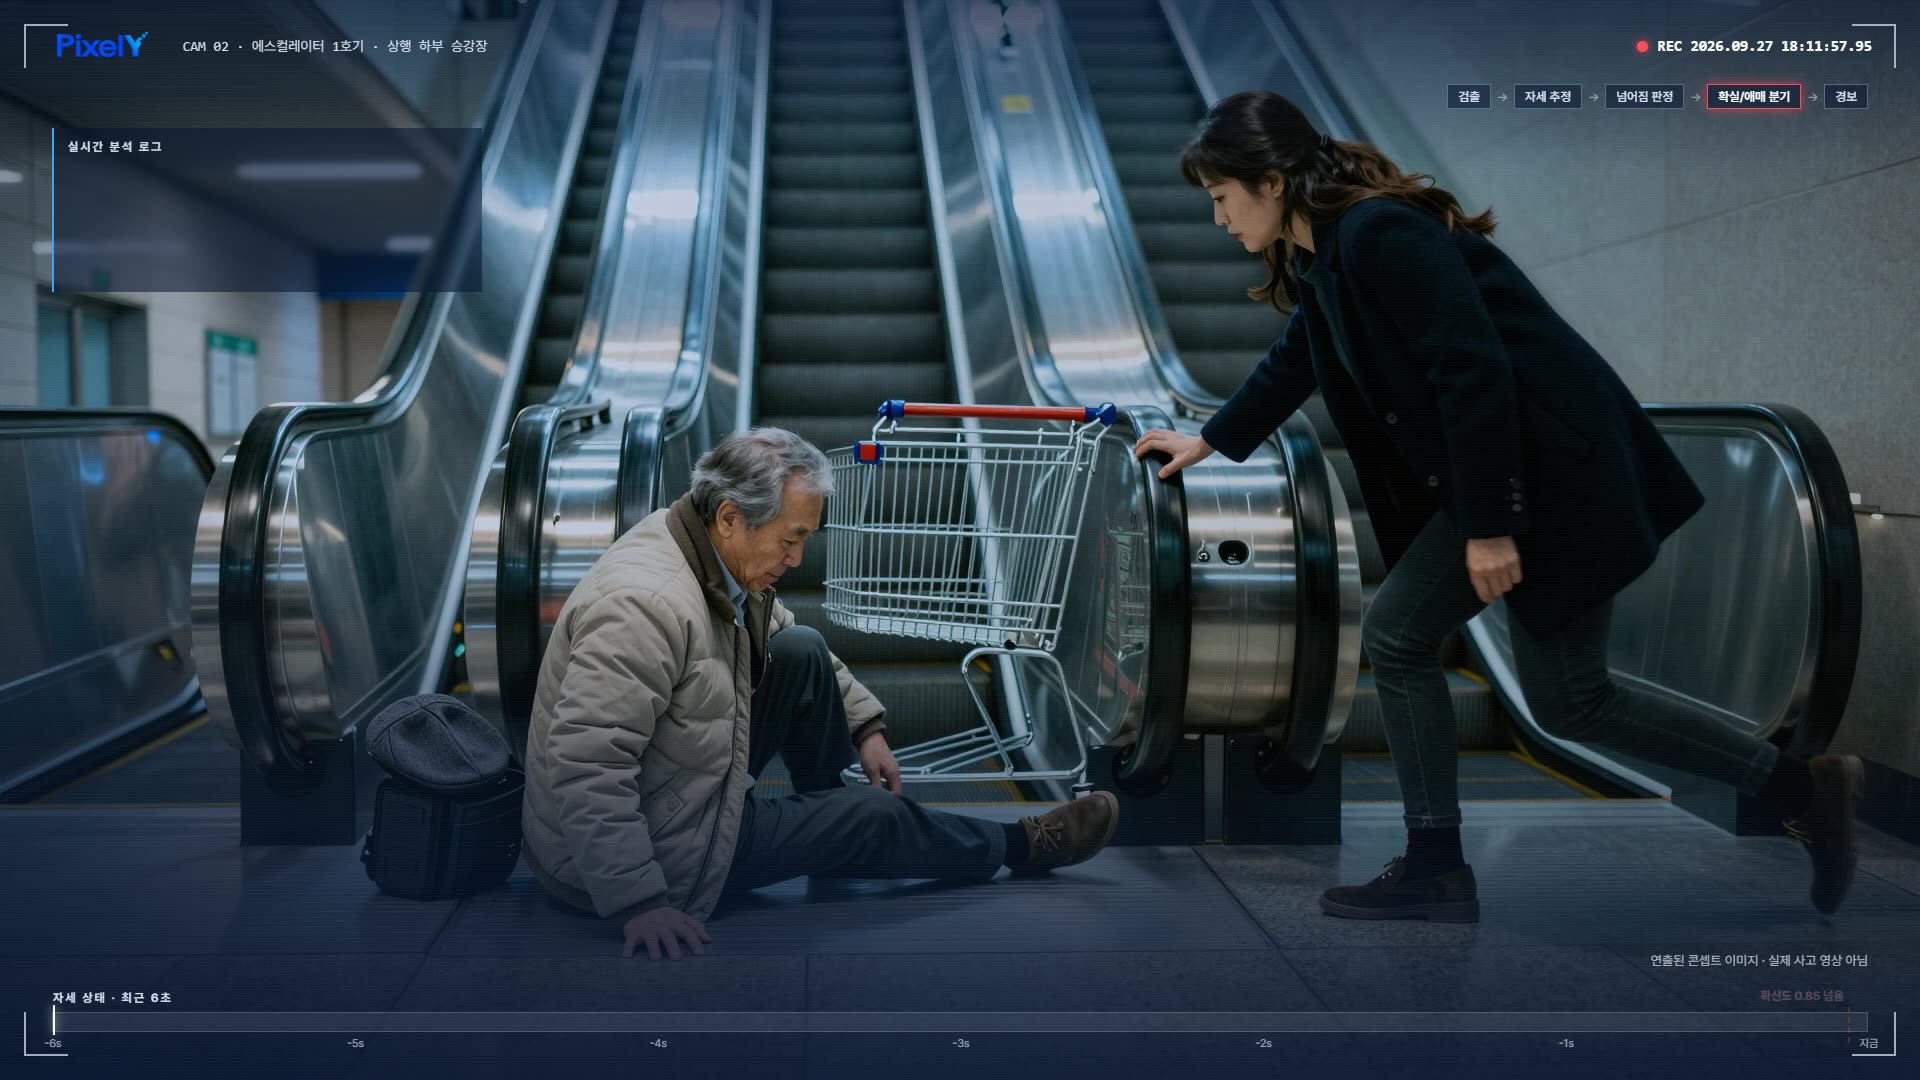
자세 변화로 먼저 감지하고, AI가 직전 장면을 다시 보며 한 번 더 확인합니다. 확실할 때만 방송하고, 애매하면 방송 없이 역무원 화면으로 넘깁니다.
Dual-Check Fall Guard · Confidence Gate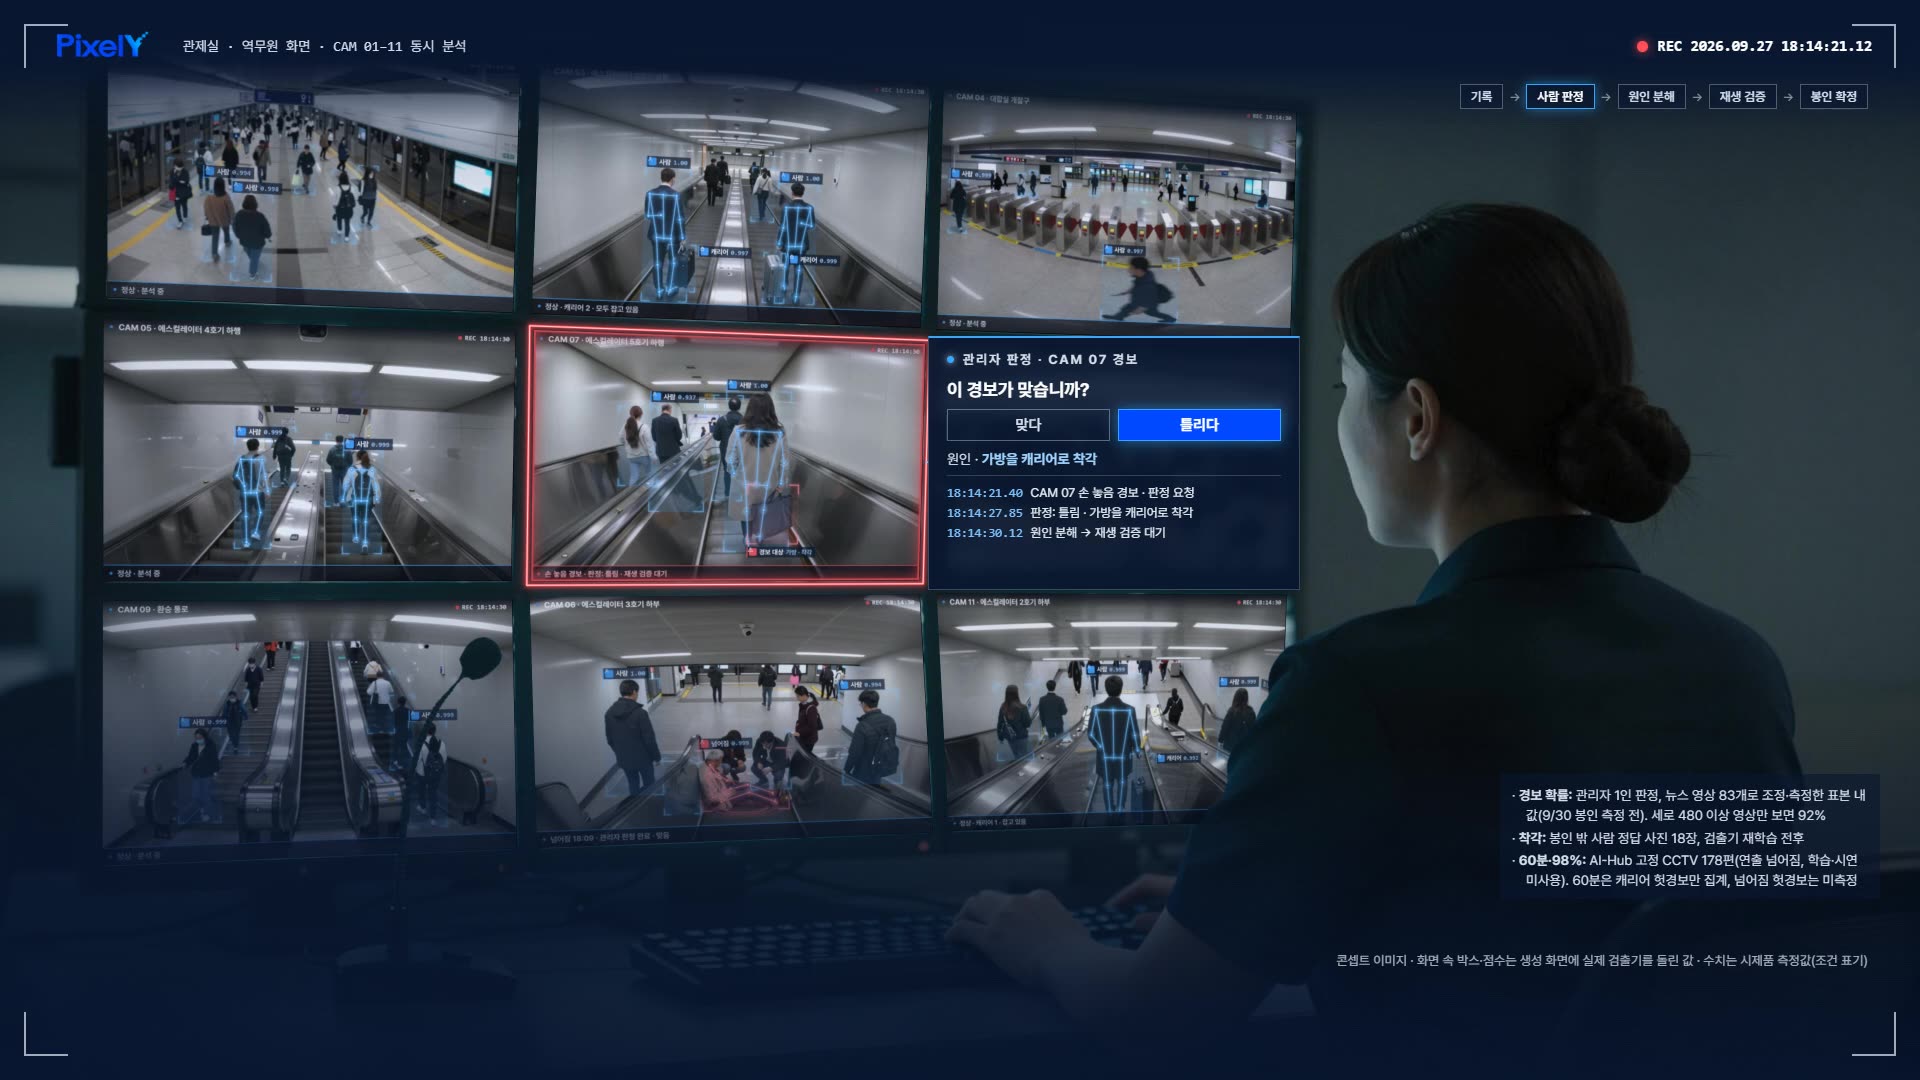
역무원은 경보마다 맞다·틀리다만 누릅니다. 틀린 원인을 찾아 고친 뒤, 저장된 기록으로 다시 검증한 수정만 새 기준으로 적용합니다.
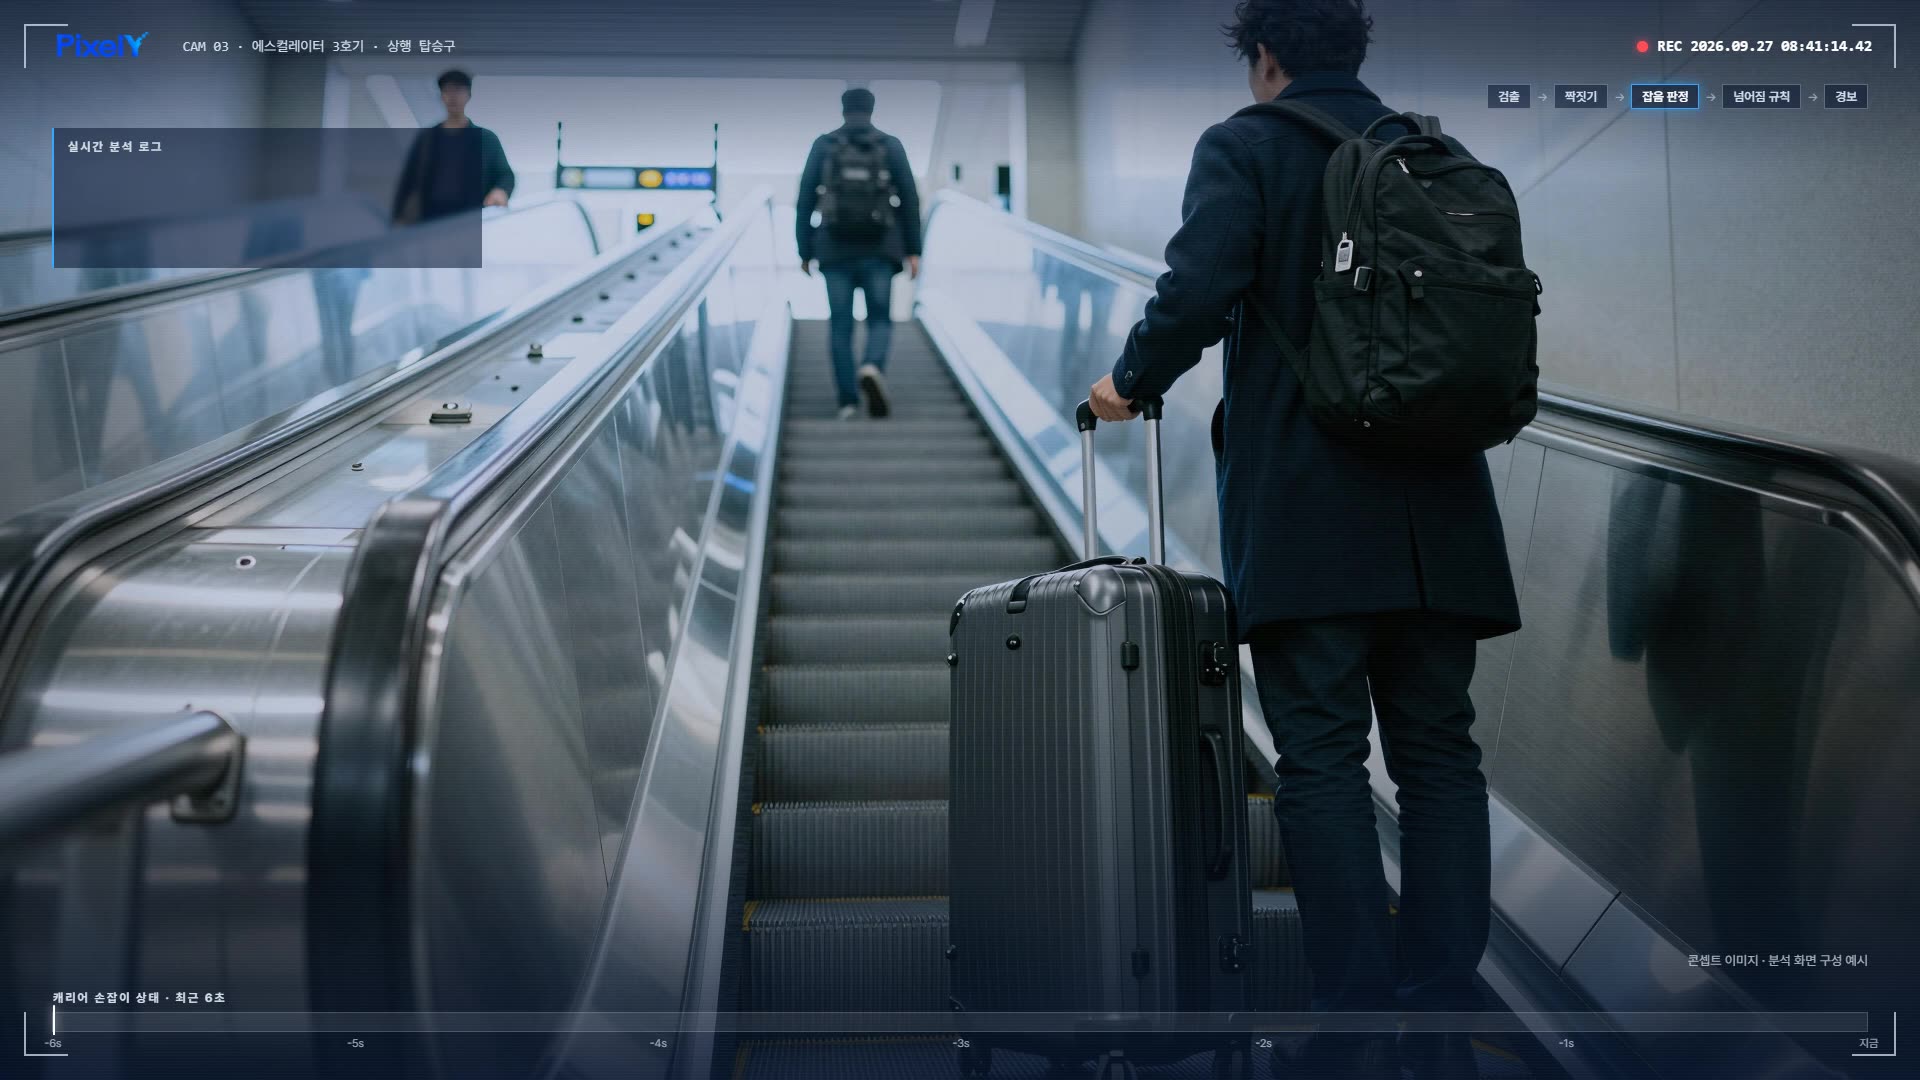
Self-Evolving Loop콘셉트 영상 · 연출된 장면이며 실제 사고 영상이 아닙니다
카메라를 새로 달지 않고, 역사 안의 서버가 판단해 안내 방송·경광등·역무원 화면으로 알립니다. 영상은 역사 밖으로 나가지 않습니다.
설계안내 방송·경광등 설비 연동
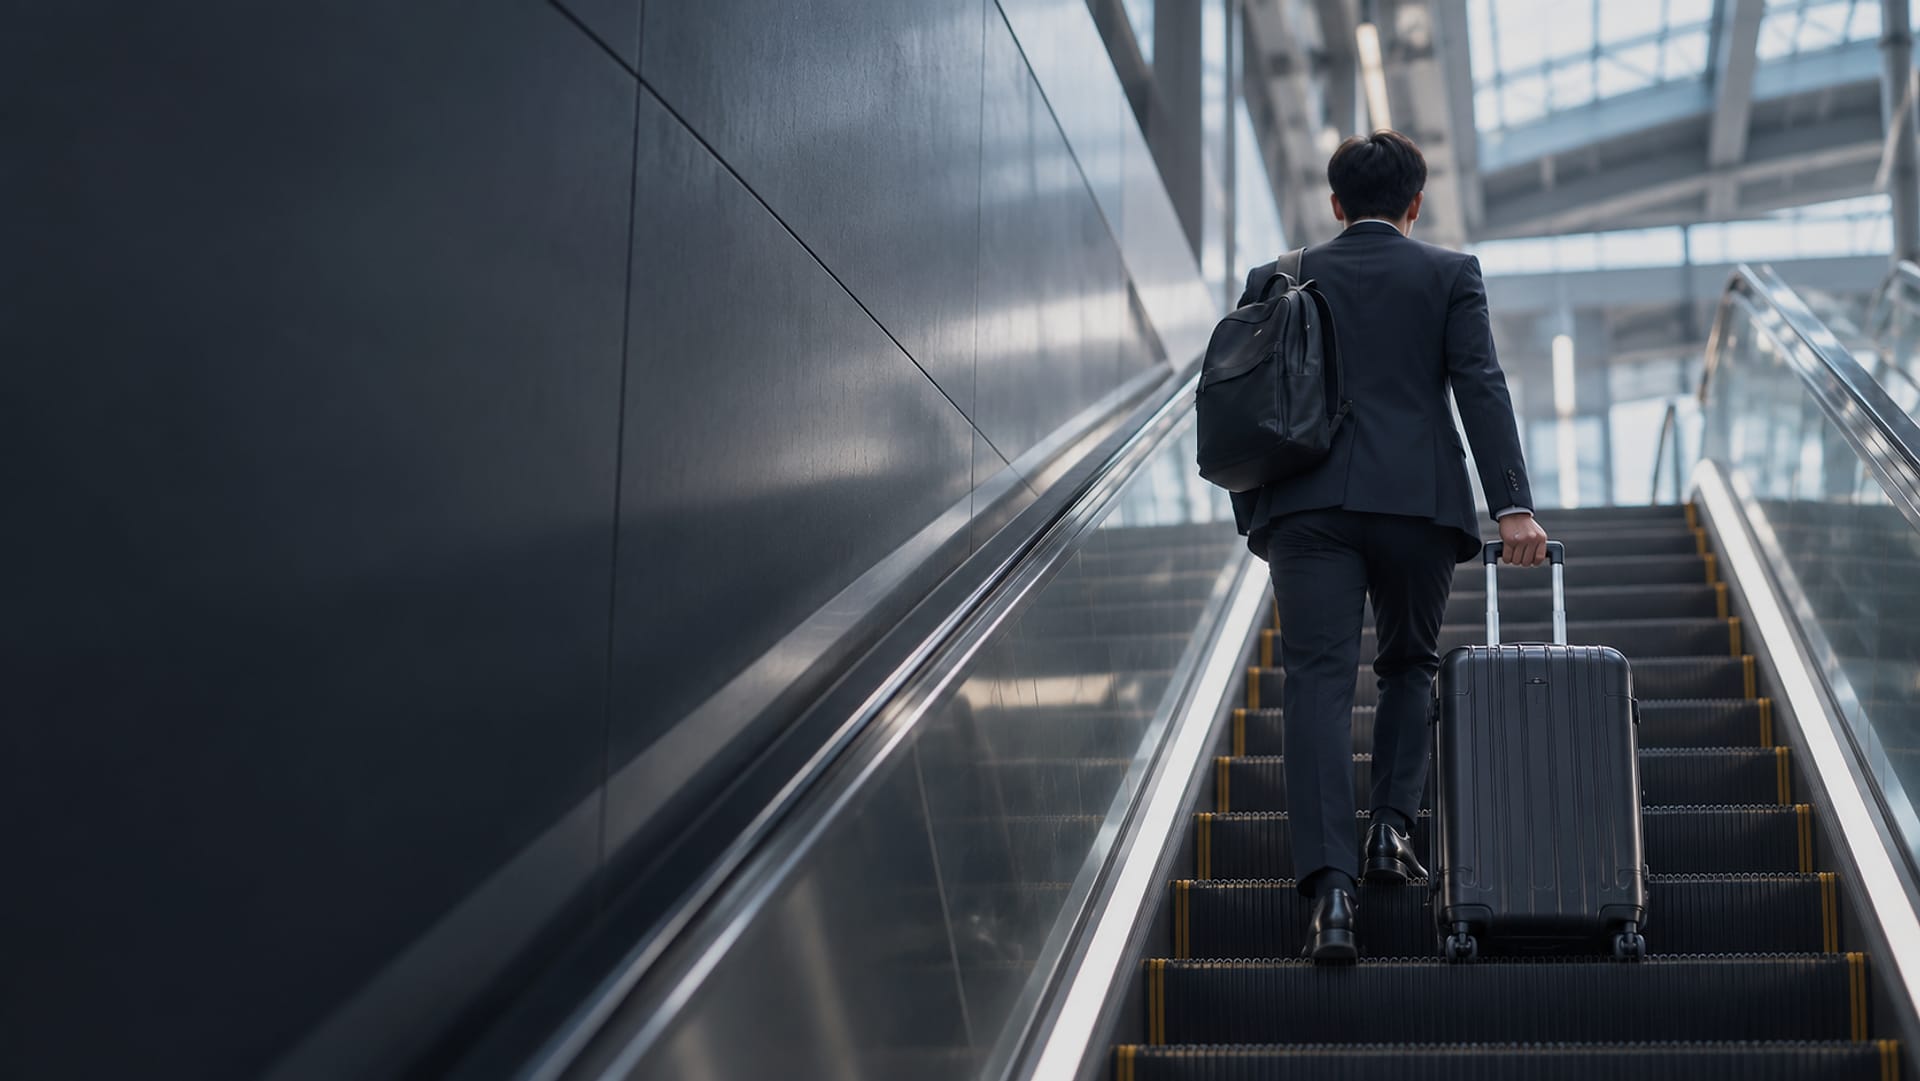
에스컬레이터 위의 8초 · 설계 예시
공개 모델을 활용하는 부분과 픽셀와이가 직접 개발·학습하는 부분을 나누고, 그 차이를 재현 가능한 비교로 보여 줍니다.
입력 · 공개 기반 구성요소
 영상
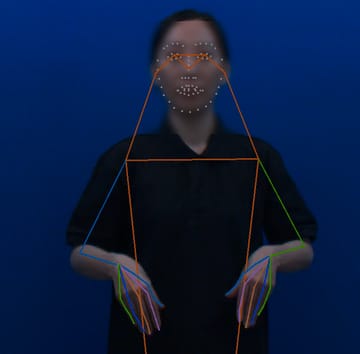 포즈 · 동작
제품화 가설
A기반 VLM·B같은 데이터로 추가 학습·C포즈 정보 단순 결합·DPixel Y 제안 구조
포즈 추정의 품질과 영상의 시각 맥락을 함께 쓰는 학습형 융합을 연구합니다. CareBridge에서 포즈 인코더와 VLM을 결합해 본 경험에서 출발합니다.
신규 R&D · CareBridge 기반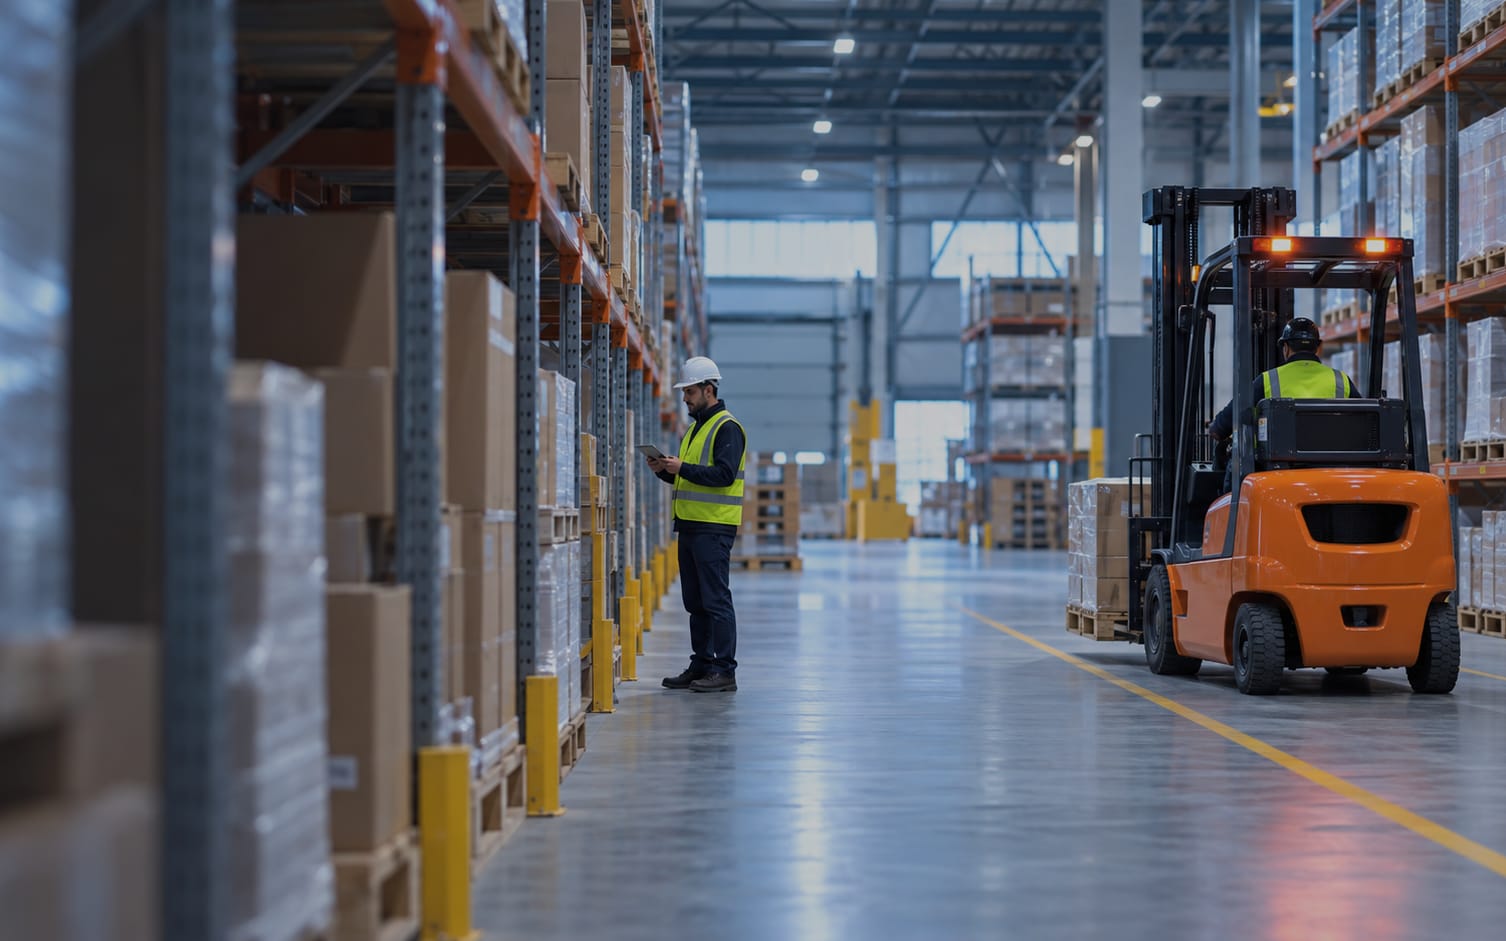 설계 예시
한 장면이 아니라 앞뒤 장면을 이어서, 행동의 순서와 사람–사물 관계, 전후 상태 변화를 유지하는 표현을 연구합니다.
신규 R&D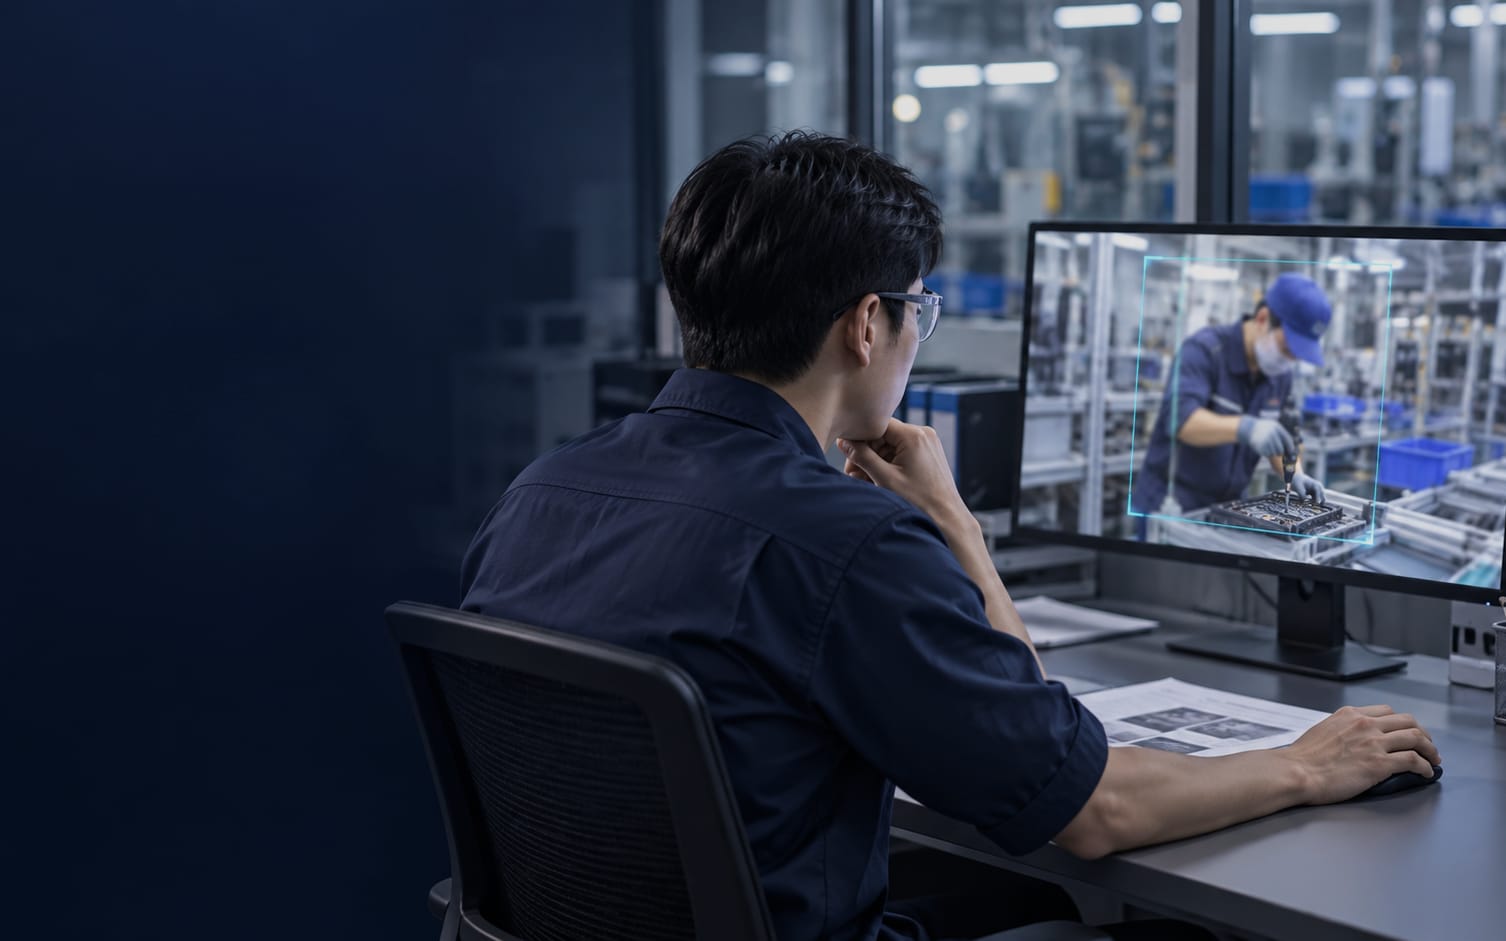 설계 예시
답마다 시간과 객체 근거를 남기고, 확인할 수 없는 구간은 판단을 보류하도록 설계합니다. 최종 결정은 사람이 내립니다.
신규 R&D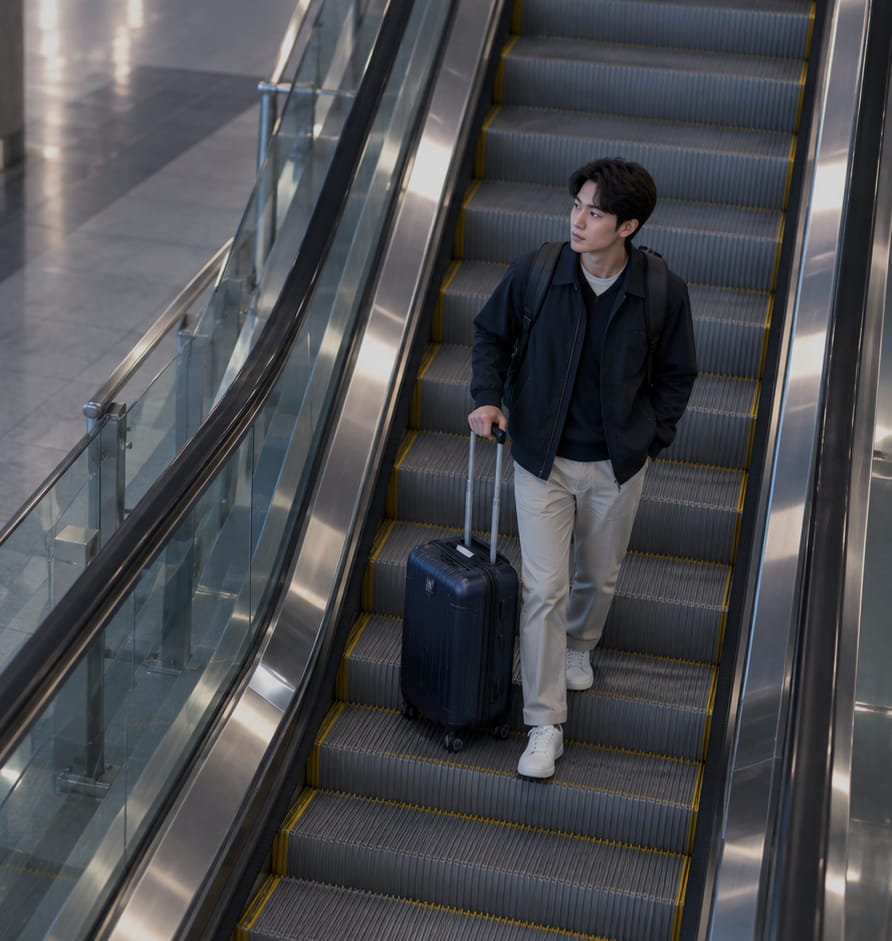 콘셉트 이미지
승객·캐리어·손잡이·넘어짐을 시간 순서로 읽고, 확신할 때만 알리는 안전 AI
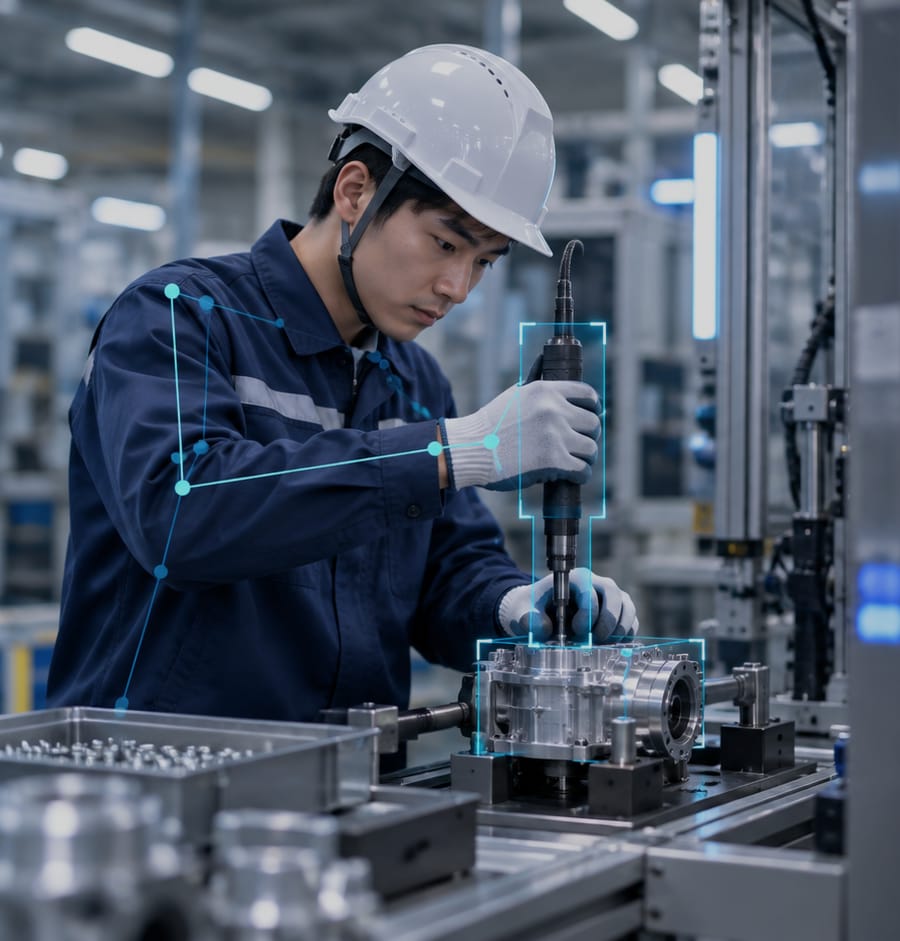 콘셉트 이미지
저장된 작업 영상을 행동·순서·상태 변화의 검토 기록으로 바꿉니다. 최종 판단은 담당자가 합니다.
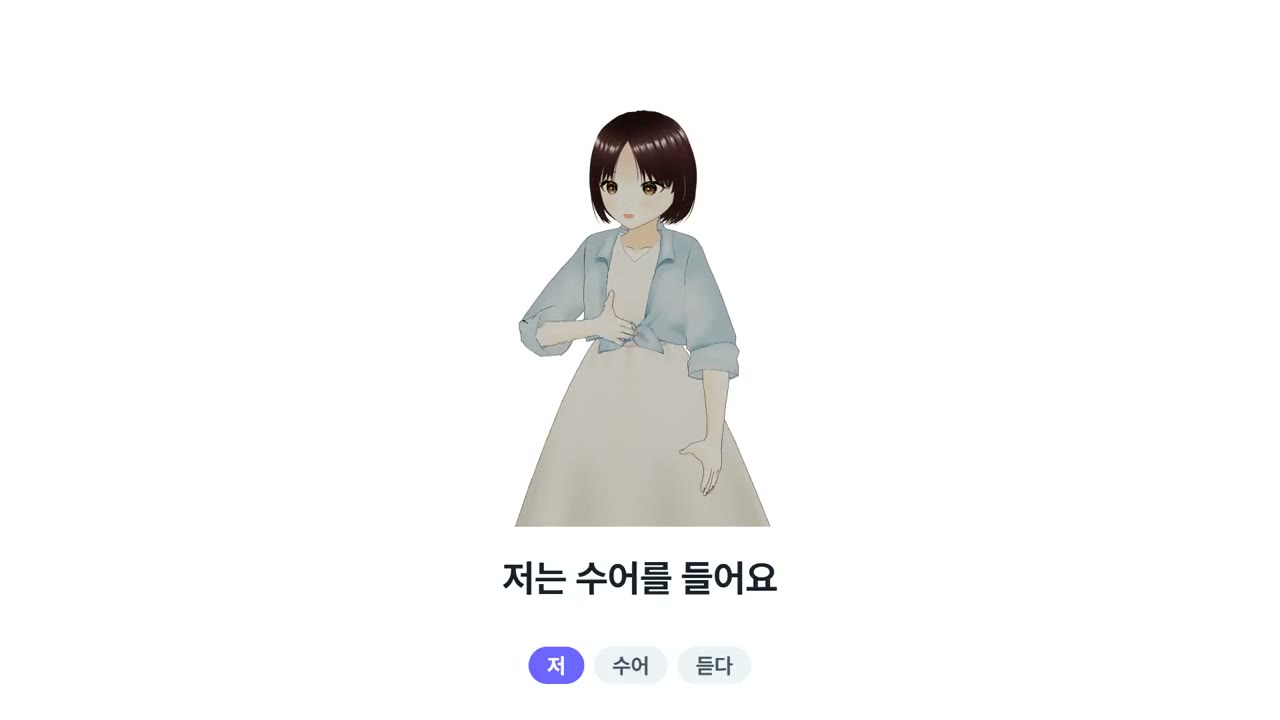
스마트폰 카메라로 한국수어를 읽고, 아바타로 답하는 앱
CareBridge 홈페이지01카메라 입력
02수어 인식
03아바타 응답
CareBridge 앱 화면
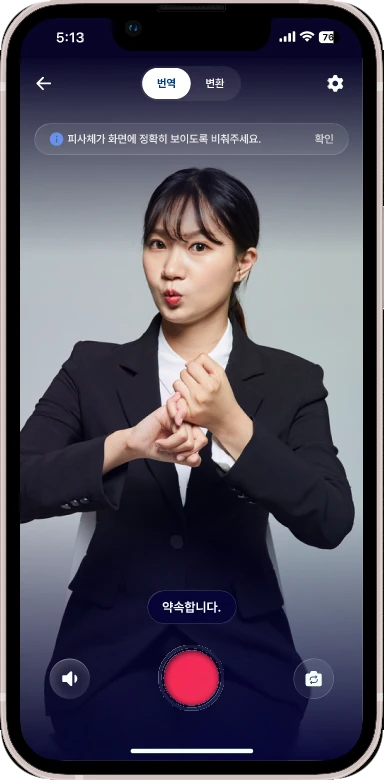 실시간 수어 번역
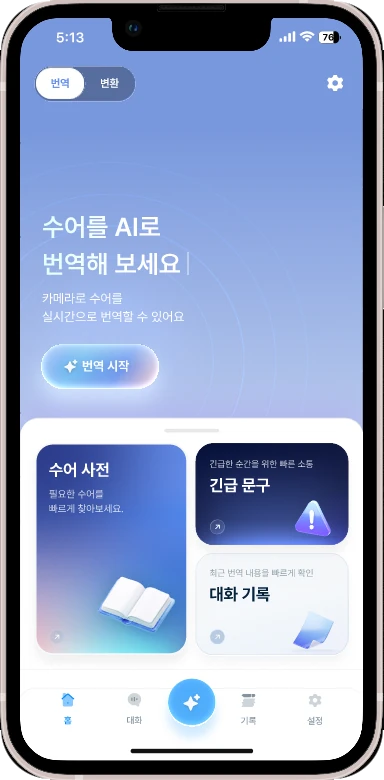 홈
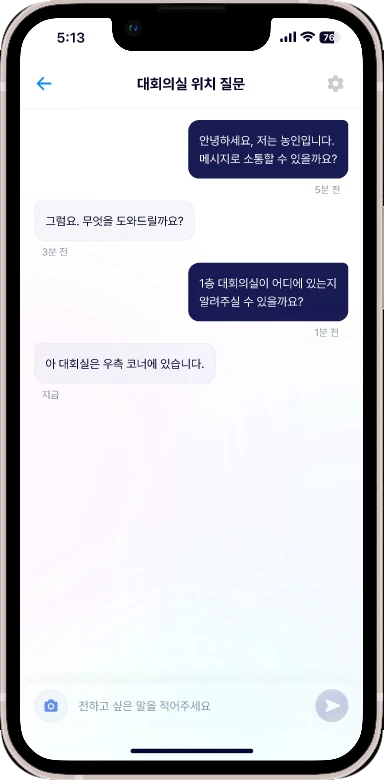 양방향 대화
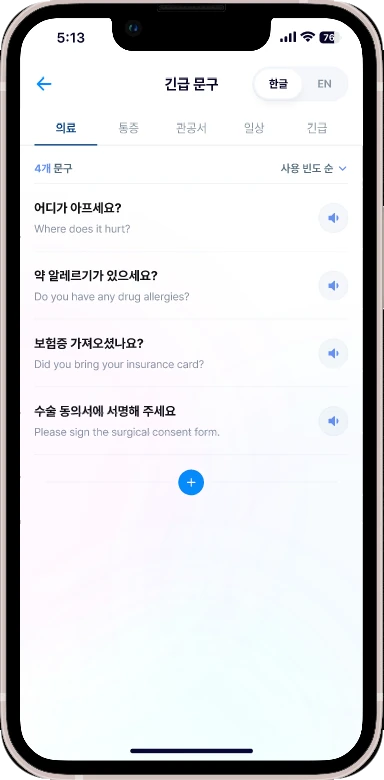 긴급 문구
청각장애인이 스마트폰 카메라 앞에서 한국 수어로 병원·관공서 화면을 조작할 수 있도록 설계합니다.
영상이 아닌 관절 움직임으로 수어를 읽는 자체 인코더. 옷·배경·조명에 덜 흔들립니다.
실측·운영지금 화면에 있는 버튼 후보로 좁혀 인식하고, 애매하면 한 번 더 확인합니다.
시제품다섯 번 보여 주면 새 단어를 재학습 없이 등록합니다.
시제품촬영 거리와 손 위치를 실시간으로 안내해, 실제 휴대폰 환경의 인식 저하를 줄입니다.
설계지금 쓰는 자료와 업무에서 필요한 AI 기능부터 함께 정해요. 기존 시스템과 연결하는 방법도 같이 살펴봐요.
개발 상담 예시 · 자료와 조건을 확인한 뒤 범위를 정해요.
기업 맞춤 AI 개발 안내영상분석, 업무 자동화, AI 기능 개발을 상담할 수 있습니다. 해결하려는 문제와 현재 시스템을 확인하고 구현 범위를 함께 정합니다. Pixel Y ST-VLM의 자체 코어는 연구·개발 중이며, 프로젝트에 적용할 기능은 상담과 PoC에서 구체화합니다.
기존 CCTV나 저장된 작업 영상을 활용하는 방향으로 검토할 수 있습니다. 영상 입력 방식, 화질, 촬영 각도, 분석할 행동을 확인한 뒤 가능한 범위와 필요한 추가 작업을 안내합니다.
해결하려는 일, 현재 쓰는 시스템과 자료의 형태, 희망 일정을 알려주세요. 영상이 있다면 촬영 환경과 확인하고 싶은 행동을 설명해주시면 좋습니다. 개인정보가 포함된 자료는 먼저 설명만 보내주세요. 상담은 jaden@pixely.kr로 시작할 수 있습니다.
현장 영상분석은 10주 PoC를 기준으로 범위를 함께 잡습니다. 분석할 대상과 목표, 평가 기준을 정하고 구현과 검증 범위를 구체화합니다. 세부 일정과 결과물은 영상 조건과 연동 요구사항을 확인한 뒤 합의합니다.
데이터 처리 위치는 프로젝트별로 정합니다. 현장 서버에서 처리하는 구성을 포함해 보안 요구와 운영 환경에 맞는 방식을 검토합니다. 영상의 저장·처리 위치와 외부 서비스 사용 여부는 PoC 범위를 정할 때 함께 확인합니다.
“이런 것도 만들 수 있나요?”
그 한 줄이면 충분해요.
개인정보나 기밀 자료는 보내지 말고,
먼저 필요한 일만 편하게 알려주세요.